
連邦航空局(FAA)のシステム障害が教える、ネットワークのレジリエンスに関する教訓
メインのネットワークがダウンし、さらにバックアップも機能しなかった場合、何が起こるでしょうか?
9月21日、まさにそのような事態が起こり、通信障害によって米国北東部全域で航空便の運航に支障をきたしました。フィラデルフィアにある連邦航空局(FAA:Federal Aviation Administration)の施設に接続する通信回線で障害が発生した際、システムがバックアップ回線への切り替えを試みたところ、そのバックアップ用の光ファイバー接続もニュージャージー州での工事中に切断されていたことが判明したのです。この障害により、ニューアーク、フィラデルフィア、JFK、ラガーディアといった主要空港で離陸停止(グラウンドストップ)や大幅な遅延が発生しました。
これは、「冗長性(リダンダンシー)」があるからといって、必ずしも「回復力(レジリエンス)」が確保されているわけではないということを、如実に物語る事例です。
真に回復力のあるアーキテクチャには、障害に耐えうる独立した経路が必要です。それによって、メインネットワークがダウンした際にも、エンジニアが重要インフラにアクセスする手段を確保できるからです。そこで重要となるのが、フェイルオーバー戦略の一環としての「アウト・オブ・バンド(OOB)管理」です。
しかし、OOBがどのように役立ち得たかを論じる前に、まずはOOBが何を行い、何を行わないのか、その役割を明確にしておきましょう。
ネットワーク管理とプロビジョニングの新たな基準 NetDevOpsプラットフォームのご紹介
本番環境のフェイルオーバーは業務運用を保護し、OOB(帯域外)フェイルオーバーは復旧プロセスを保護します
まず明確にしておきたいのは、OOB管理のフェイルオーバーがあったとしても、FAA(連邦航空局)で発生したような障害は防げなかっただろうということです。レーダーデータや管制官とパイロット間の通信は、それら専用に設計・認証され、十分な性能を備えた本番環境用フェイルオーバー・アーキテクチャを必要とするため、OOBの仕組みではこれらを伝送できないからです。
OOBフェイルオーバーが解決するのは、全く別の課題です。
それは、「通常使用しているネットワークがダウンした際、エンジニアはいかにしてインフラにアクセスするか」という点です。
なぜこれが重要なのか
本番環境で障害が発生した際、最優先事項は接続性を回復させることですが、それ以外にも実行すべき復旧プロセス全体が存在します。エンジニアは、何が故障したのかを特定し、サービスを復旧させるために必要な措置を講じるべく、ルータ、スイッチ、ファイアウォールなどの機器にアクセスできる必要があります。
ここにOOB(アウト・オブ・バンド)の価値があります。OOBは本番ネットワークを置き換えたり、その代わりを務めたりするものではありません。OOBはエンジニアに対し、機器への「別ルート」を提供します。このルートを活用することで、障害の診断、ネットワークの再設定、利用可能なバックアップ経路の有効化、そして接続性が回復した直後にサービスを再開できるようインフラを準備することが可能になります。
OOBがなければ、接続性が回復した後にオンライン状態に戻すには、誰かが物理的に機器の設置場所へ到着するのを何時間も待つ必要が生じ、以下のような事態を招きます。
- 復旧時間の長期化
- 現地への出動(トラックロール)の増加
- 業務へのさらなる支障
- 現地担当者への依存
- 障害発生時の可視性の低下
FAA(連邦航空局)の事例で言えば、OOBがあったとしてもネットワークをオンラインに保つことはできなかったでしょう。しかし、本番経路が使用できない間でも、エンジニアがインフラに対して作業を行う手段は確保できたはずです。迅速な復旧を実現する上で、この点は決定的な違いをもたらします。これこそが、単なる冗長化だけでは真のレジリエンス(回復力)を確保できない理由なのです。
「2つの接続」か、それとも「2つの経路」か?
危機管理の分野には「2つ備えてようやく一人前、予備がなければ無いに等しい」という格言があります。しかし、ネットワークの世界において、単に冗長性を持たせただけでは、必ずしも障害に対する十分な備えになるとは限りません。
メインの接続とバックアップの接続が、同じ通信事業者、物理的な経路、あるいはインフラを共有している場合、光ファイバーの切断といった一つのトラブルが双方に影響を及ぼしてしまいます。まさに連邦航空局の事例で起きたのがこの事態であり、その結果、エンジニアはインフラにアクセスできなくなりました。ここで重要になるのが、「リダンダンシー(Redundancy:冗長性)」と「レジリエンス(Resilience:回復力・強靭性)」の違いを理解することです。
- 冗長性とは、「バックアップ接続があるか?」を問うものです。
- レジリエンスとは、「障害が発生した際、現地(オンサイト)に行かずにインフラへアクセスできるか?」を問うものです。
もし連邦航空局が、光ファイバー切断の影響を受けない5G回線などをバックアップとして導入していたらどうなっていたでしょうか。彼らは遠隔からインフラにアクセスし、復旧作業を迅速に進めることができたはずです。アウト・オブ・バンド(帯域外)通信を真に「アウト・オブ・バンド」なものにする鍵は、本番用ネットワークから論理的にも物理的にも完全に分離された、専用の回線を確保することにあります。
では、具体的にどのような構成になるのでしょうか?回復力のある復旧経路の構築
アウト・オブ・バンド(OOB)通信では、別のISP(利用可能な場合)やMPLS、あるいは5G/LTEや衛星通信といった、従来の地上インフラに依存しない回線タイプを利用できます。このような回復力のあるOOB管理経路を構築するには、本番環境のインフラに接続するシリアルコンソールサーバーを導入し、それらへのリモートアクセス専用のセルラーモデムや衛星通信接続などを利用します。
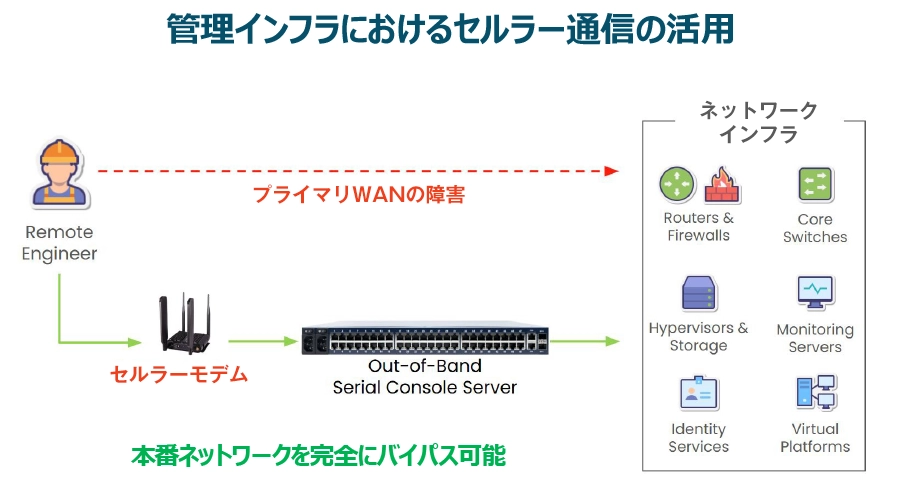
これにより、エンジニアは本番ネットワークを完全に迂回しつつ、本番環境のすべてのインフラにリモートからアクセスできるようになります。その結果、以下のような対応が可能になります。
- 障害が発生したインフラの診断
- デバイスのコンソールへのアクセス
- ルーティングの変更
- バックアップ回線の有効化
- 設定のロールバック
- 機器の再起動
- 分散拠点間での復旧作業の調整
プライマリWANを「単一障害点(SPOF)」と見なすなら、アウト・オブ・バンドは「セーフティネット」と言えます。WANの障害によって業務が中断・混乱に陥った際、アウト・オブ・バンドがその状況を支え、システムの復旧をより容易かつ迅速に行えるようにします。
OOB経路の構築と完全な分離が完了したら、さらに重要なステップがもう一つあります。
OOB(帯域外)パスのテスト
OOBインフラを構築するのは素晴らしい第一歩ですが、単なる「回復力があるという思い込み」に陥らないよう、実際にすべてが機能することを確認する必要があります。いざという時にセーフティネットを使おうとして、SIMやAPN(Access Point Name)の設定が適切でなかったと判明するような事態は避けなければなりません。
以下にいくつかのポイントを挙げます。
- SIMカードが適切にプロビジョニングおよび有効化されていること、またAPN設定が正しいことを確認してください。
- メインの接続が切断されたことをシステムが検知し、自動的にバックアップ回線へフェイルオーバーできることを確認してください。
- フェイルオーバーからトラブルシューティング、そしてフェイルバックに至るまで、復旧のワークフロー全体をテストしてください。
重要なポイント:復旧への経路を確保する
連邦航空局のシステム障害が示した教訓は、バックアップというものは、想定される障害に耐えうるものでなければ役に立たないということです。しかし、たとえバックアップが利用可能であっても、それだけでは不十分であり、専用の管理経路(マネジメントパス)が必要となります。この経路は、安全なリモートアクセスを維持し、接続が復旧した際に即座に稼働できるようインフラを準備するために不可欠であり、迅速な復旧を実現する鍵となります。
こうした背景から、多くの組織がZPE Systems社の「Nodegrid」を活用し、次世代のアウト・オブ・バンド管理手法である「IMI(Isolated Management Infrastructure:隔離型管理インフラ)」を導入しています。Nodegridは、アウト・オブ・バンド管理、複数のフェイルオーバー回線、一元管理、そしてリモート復旧機能を、効率化された単一のアーキテクチャに統合しています。
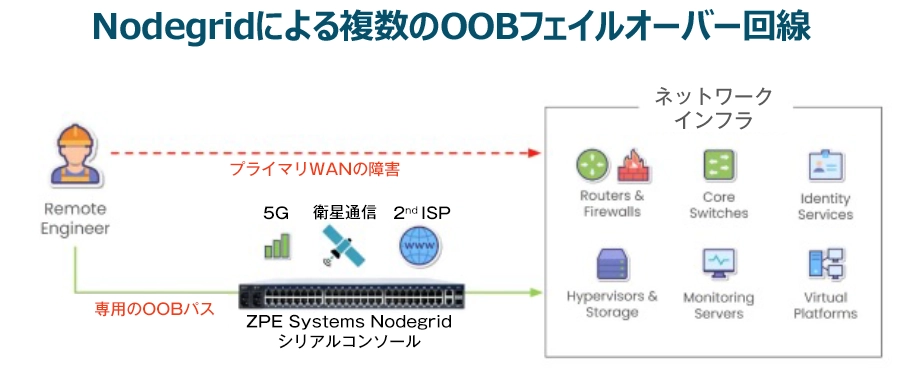
Nodegridデバイスを1台導入するだけで、ルーター、スイッチ、ファイアウォール、サーバー、その他あらゆる重要機器に対して、シリアル、イーサネット、USB経由でのアクセスが可能になります。また、フェイルオーバーに関しては、追加の機器を増設することなく、5G(内蔵モデムを使用)、衛星通信、MPLSなど、多様な回線タイプに対応しています。
その結果、重要インフラへのアクセスを維持する独立した経路が確保され、エンジニアはリモートから問題の診断や復旧作業を行えるようになり、現地での作業への依存度を低減することが可能になります。
予期せぬ事態でも制御を維持する
強靭なOOB(帯域外)フェイルオーバー導入ガイドをダウンロード
「バックアップ回線を超えて:ネットワークの強靭性を高める5Gフェイルオーバー」では、メイン回線に障害が発生した際、セルラー通信がいかにして重要インフラの管理・復旧のための独立した通信経路を提供できるかを解説しています。本ガイドでは、ネットワークの強靭性を高める包括的な戦略の一環として、セルラーや衛星通信などの回線を導入する際の5つの重要な検討事項を取り上げています。
ガイドをダウンロードして、メインネットワークの停止時にも接続を維持できるフェイルオーバー戦略の構築方法を学びましょう。